CH 17 · 로컬 배포와 Token 자유
본장 목표
앞선 모든 장에서는 DeepSeek 공식 API를 호출해 왔습니다 — 쓸 만하지만, 토큰당 과금이며, 특히 Agent 세션은 토큰을 많이 먹습니다 (모든 도구 결과가 컨텍스트로 다시 들어가야 합니다). 그리고 이것은 DeepSeek만의 문제가 아닙니다. 클라우드 API를 거치는 한, 공식이든 제3자든, 토큰당 과금에서 벗어날 수 없습니다.
이번 장은 완전히 다른 길을 제시합니다. 로컬 배포. 오픈소스 모델을 자신의 컴퓨터에 받아 돌리고, 추론 전체가 어떤 제3자 서버도 거치지 않습니다 — 토큰 요금 없음, 진정한 "Token 자유".
CH 07에서 이미 배운 방법이 있습니다. dsh는 "OpenAI 호환 엔드포인트"만 인식하며, 모델은 구성이지 묶음이 아닙니다. 이번 장에서는 그 능력을 실제 시나리오에 적용합니다 — dsh가 자신의 모델로 동작하게 하기.
로컬 배포는 클라우드와 무엇이 다른가
먼저 "왜 로컬 배포가 무료인지" 분명히 합니다. DeepSeek 공식 API를 사용할 때, 프롬프트, 도구 결과, 파일 내용이 모두 그 서버로 보내지며, 서버는 자기 GPU로 추론을 한 뒤 토큰당 과금합니다. 모든 클라우드 API가 이렇습니다. 연산은 남의 것이고, 비용은 토큰을 따라옵니다.
로컬 배포는 정반대입니다. 모델이 자신의 컴퓨터에 다운로드되고, 추론이 자신의 GPU/CPU 위에서 돌아가며, 어떤 제3자 서버도 관여하지 않습니다. 연산도 자신의 것이고, 전기세도 자신의 것이므로 당연히 토큰당 비용이 없습니다 — 이것이 "Token 자유"의 진짜 의미입니다.
| 차원 | 클라우드 API (예: DeepSeek 공식) | 로컬 배포 (LM Studio로 오픈소스 모델 실행) |
|---|---|---|
| 과금 | 토큰당 과금 | 무료 (전기세만) |
| 네트워크 | 인터넷 연결 필수 | 완전한 오프라인 가능 |
| 데이터 | 서비스 제공자 서버로 보냄 | 자신의 컴퓨터에 머무름 |
| 능력 | 플래그십 모델, 가장 강력 | GPU가 돌릴 수 있는 모델 크기에 따라 좌우 |
| 진입 비용 | 0, 가입만 하면 Key를 받음 | 소프트웨어 설치, 모델 다운로드 (수 GB) |
로컬 배포의 특징을 한 줄로: 무료, 오프라인, 사적 — 다만 능력은 하드웨어에 따라 제한됩니다 — GPU가 강할수록 더 큰 모델을 돌릴 수 있고 결과도 좋습니다.
원리: 모델은 구성이다
왜 dsh가 모델을 마음대로 바꿀 수 있는지가 모델 라우팅 플러그인 llm-pi-ai 때문입니다. 이것은 "모델 제공자"를 YAML 구성 한 조각으로 취급하며, OpenAI Chat Completions 프로토콜을 노출하는 어떤 엔드포인트(즉 /v1/chat/completions)도 제공자로 꽂을 수 있습니다. 모델 바꾸기 = 구성 한 조각 바꾸기, dsh 자체를 바꿀 필요 없음.
따라서 로컬 배포와 공식 API 연결의 방법은 CH 07과 같으며, 다른 것은 엔드포인트 주소뿐입니다.
| 방향 | Base URL | Key | 전형적인 모델 |
|---|---|---|---|
| DeepSeek 공식 (클라우드) | https://api.deepseek.com | 공식 Key | deepseek-v4-flash 등 |
| LM Studio 로컬 | http://localhost:1234/v1 | 무엇이든 (로컬은 검증하지 않음) | Qwen3 8B 등 |
로컬 모델 연결: LM Studio 온보딩
1단계: LM Studio 설치, 모델 다운로드
로컬 모델 러너는 하나뿐이 아닙니다. Ollama에 익숙하다면 Ollama를 직접 써도 됩니다 (명령줄 온보딩이며, 구성 방법은 아래와 동일). 이번 장에서는 LM Studio로 통일해 데모합니다 — 그래픽 인터페이스라 초보자에게 가장 친절합니다.
LM Studio는 Windows / macOS / Linux를 지원합니다. LM Studio 웹사이트에서 설치 프로그램을 받습니다. 설치 후, 어떤 모델을 받을지 추측하지 마시고, 그 일은 dsh에게 맡깁니다 — dsh가 컴퓨터 환경을 점검한 뒤 추천해 줍니다. Web UI 입력창에 다음을 보냅니다.
내 컴퓨터의 GPU와 VRAM을 확인하고, Q4 양자화에서 로컬 모델이 어느 정도 크기까지 편하게 돌릴 수 있는지 추정해 주세요. 로컬 Agent에 적합한 모델 2~3개를 추천하고, LM Studio 검색창에서 바로 검색 가능한 모델명을 제시하며, 각 모델에 대해 한 줄 이유를 적어 주세요. 조회와 추천만, 다른 작업은 하지 마세요.dsh가 GPU를 읽어내어 구체적인 모델 이름을 몇 개 나열합니다. 그 이름을 LM Studio에서 검색합니다.
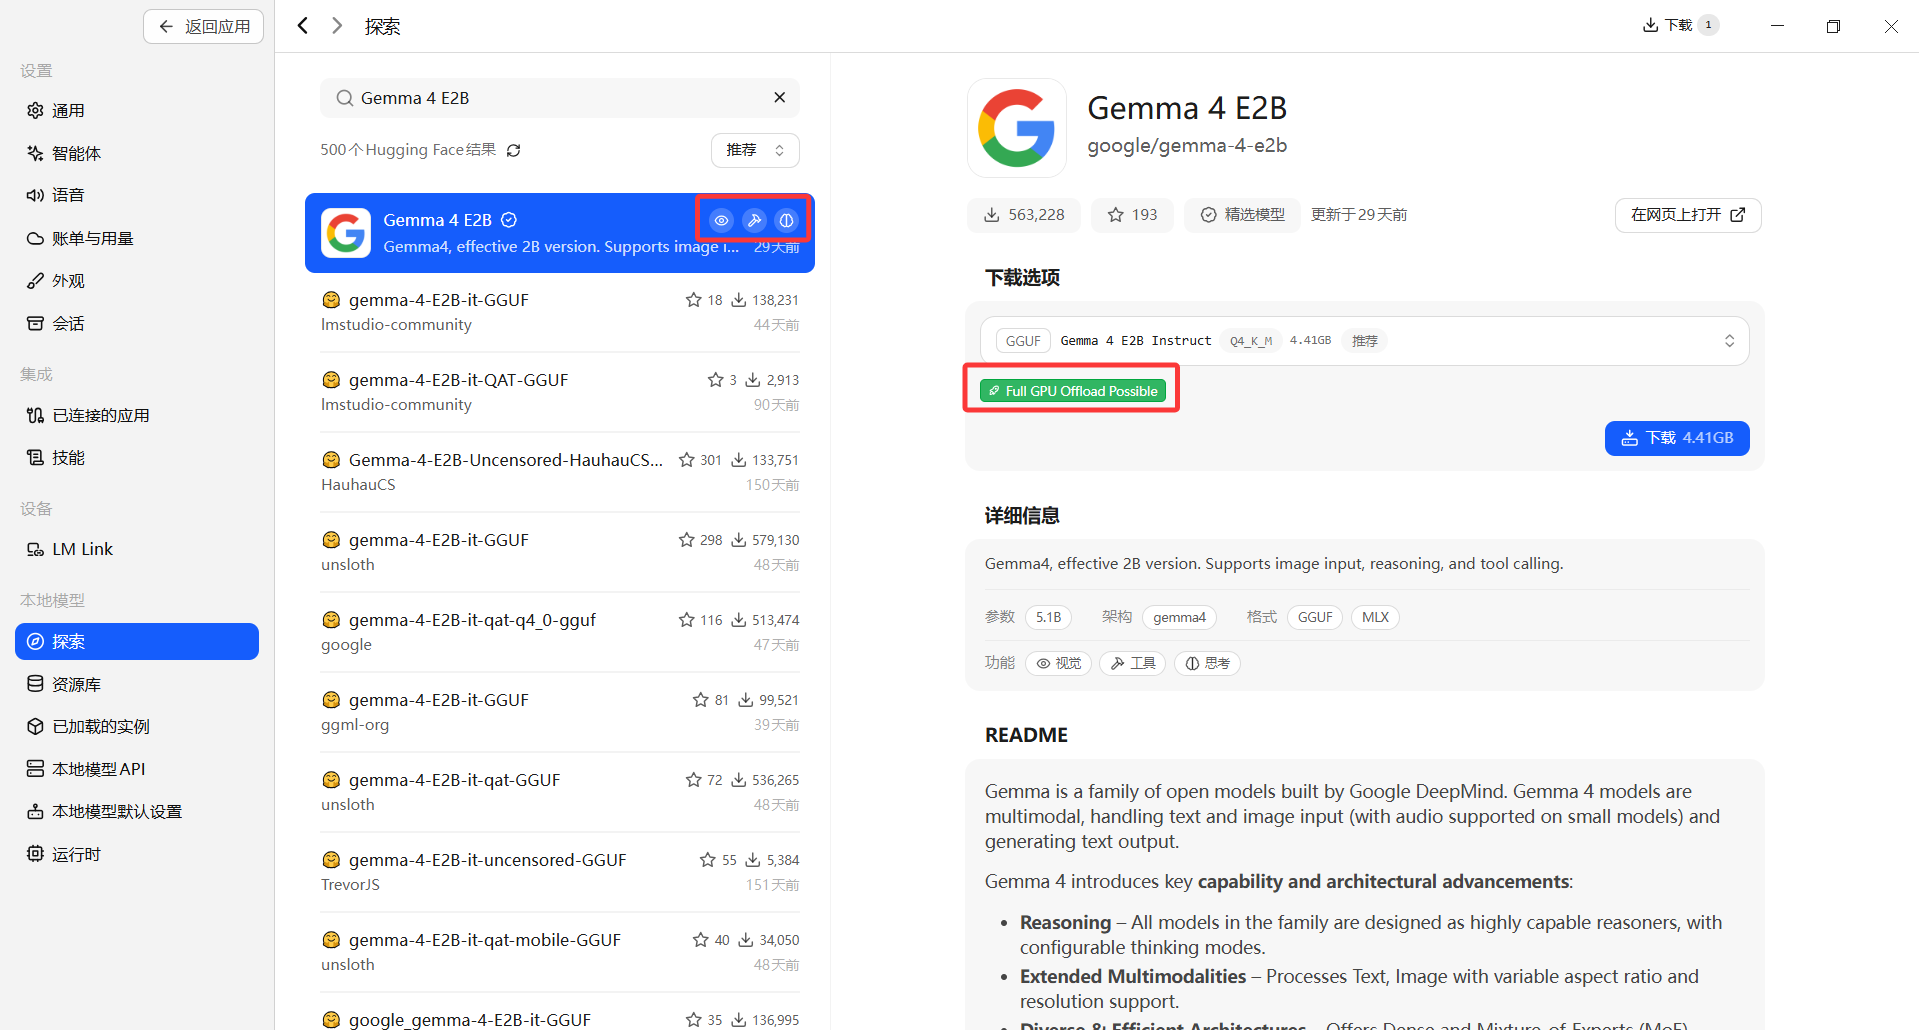
LM Studio를 엽니다. 좌하단 Settings → Explorer, 검색창에 dsh가 추천한 모델 이름을 입력합니다. 검색 결과에서 **녹색 라벨(하드웨어 호환, 전체 GPU 로드 가능)**이 붙은 것이 본인 컴퓨터에서 돌릴 수 있는 것이며, 클릭해 다운로드합니다.
변하지 않는 한 가지 상기 사항: Agent를 돌릴 로컬 모델에 있어, 도구 호출 능력이 벤치마크 점수보다 더 중요합니다 — 모델이 지시를 따라 도구를 부를 수 있어야 하며, 그렇지 않으면 Agent는 움직일 수 없습니다.
2단계: 로컬 서버를 켜고 엔드포인트 동작 확인
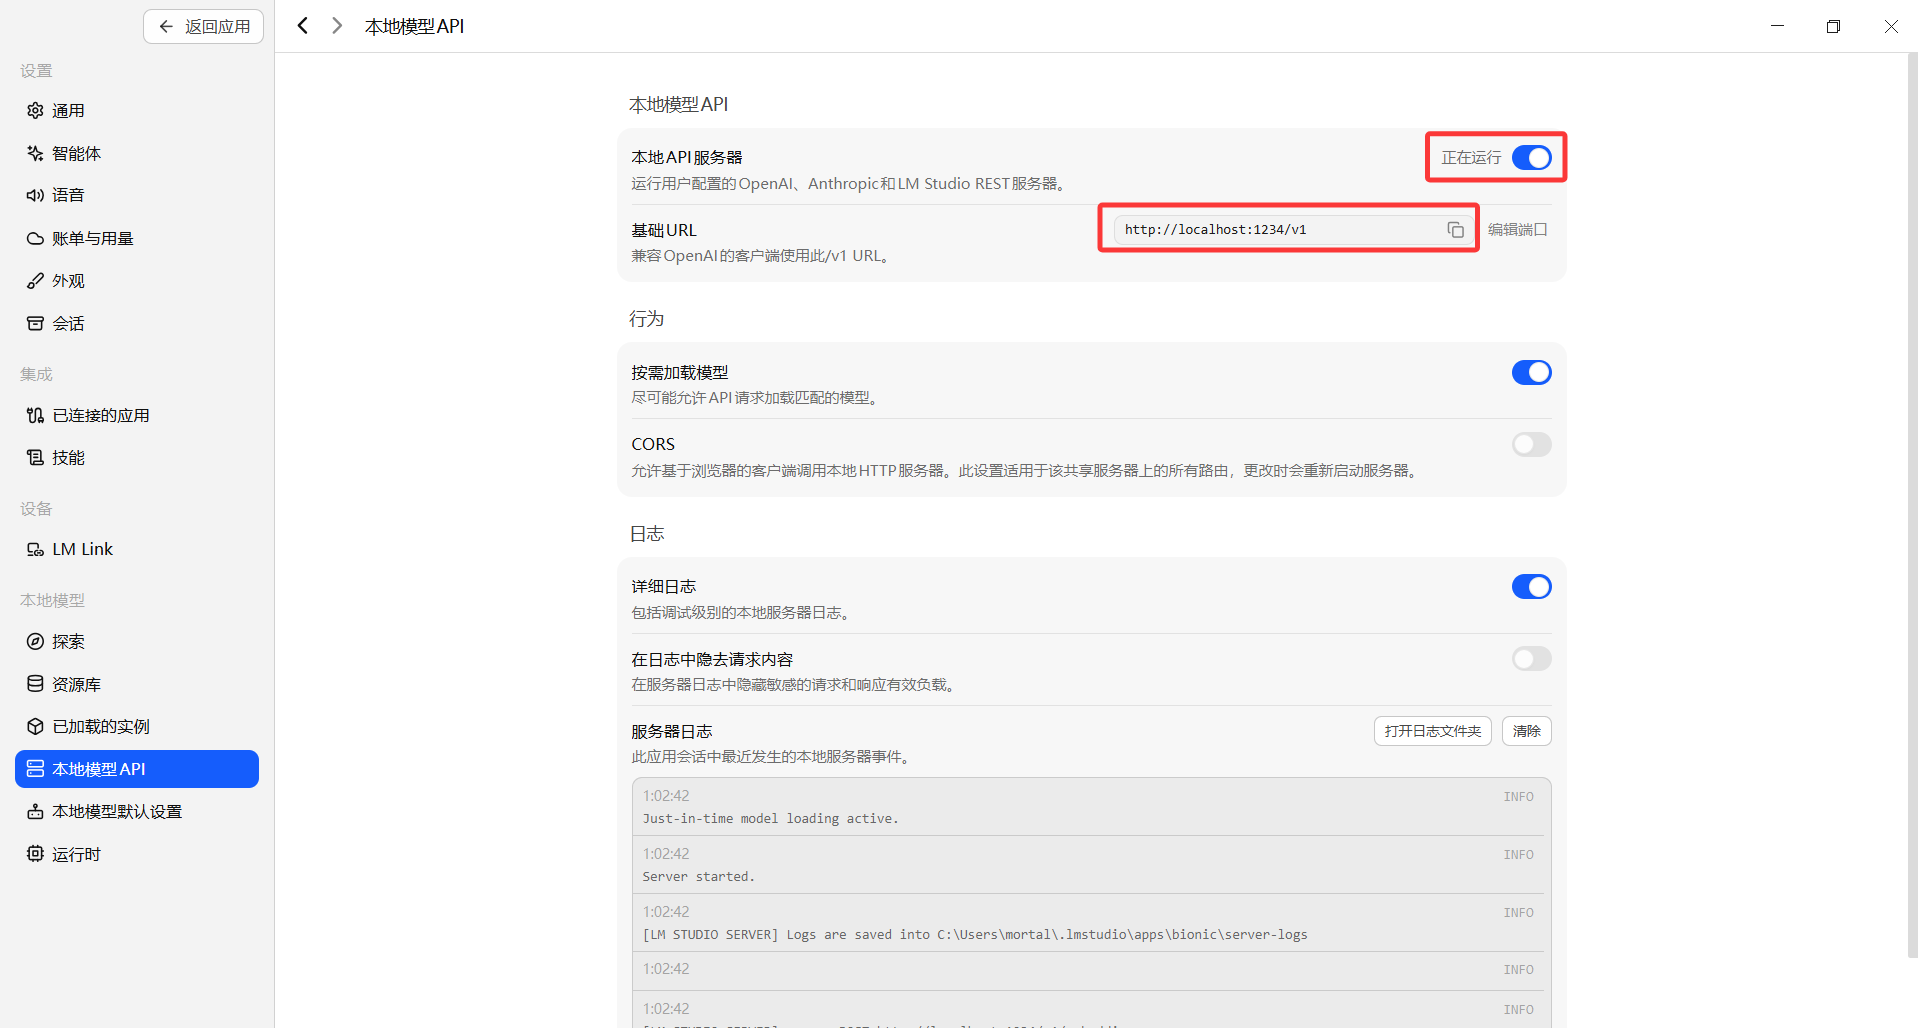
모델 다운로드가 끝난 뒤, LM Studio 좌하단 Settings → Local Models → Local Model API (Local Server)로 가서 Local API server 스위치를 켭니다. 기본적으로 http://localhost:1234에서 청취하며, OpenAI 호환 엔드포인트는 /v1에 있습니다 — 페이지에 base URL http://localhost:1234/v1이 직접 표시되고, "running"이 보이면 서버가 떠 있는 것입니다.
브라우저에서 다음을 엽니다.
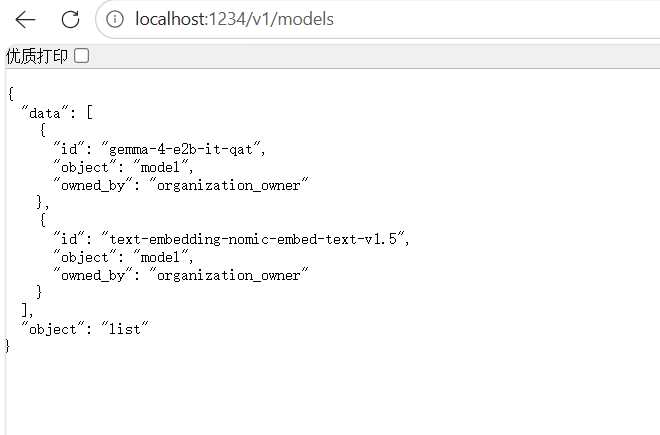
http://localhost:1234/v1/models다운로드한 모델을 나열한 JSON이 보이면 엔드포인트는 정상입니다. 이 단계에서는 또한 각 모델의 정확한 ID를 알 수 있습니다 (여기서 반환된 것을 그대로 쓰십시오. 예: 제가 다운로드한 Gemma 4 E2B는 gemma-4-e2b-it-qat로 표시됨), 이후 구성에 채워 넣어야 합니다.
리소스 라이브러리의 모델 매개변수
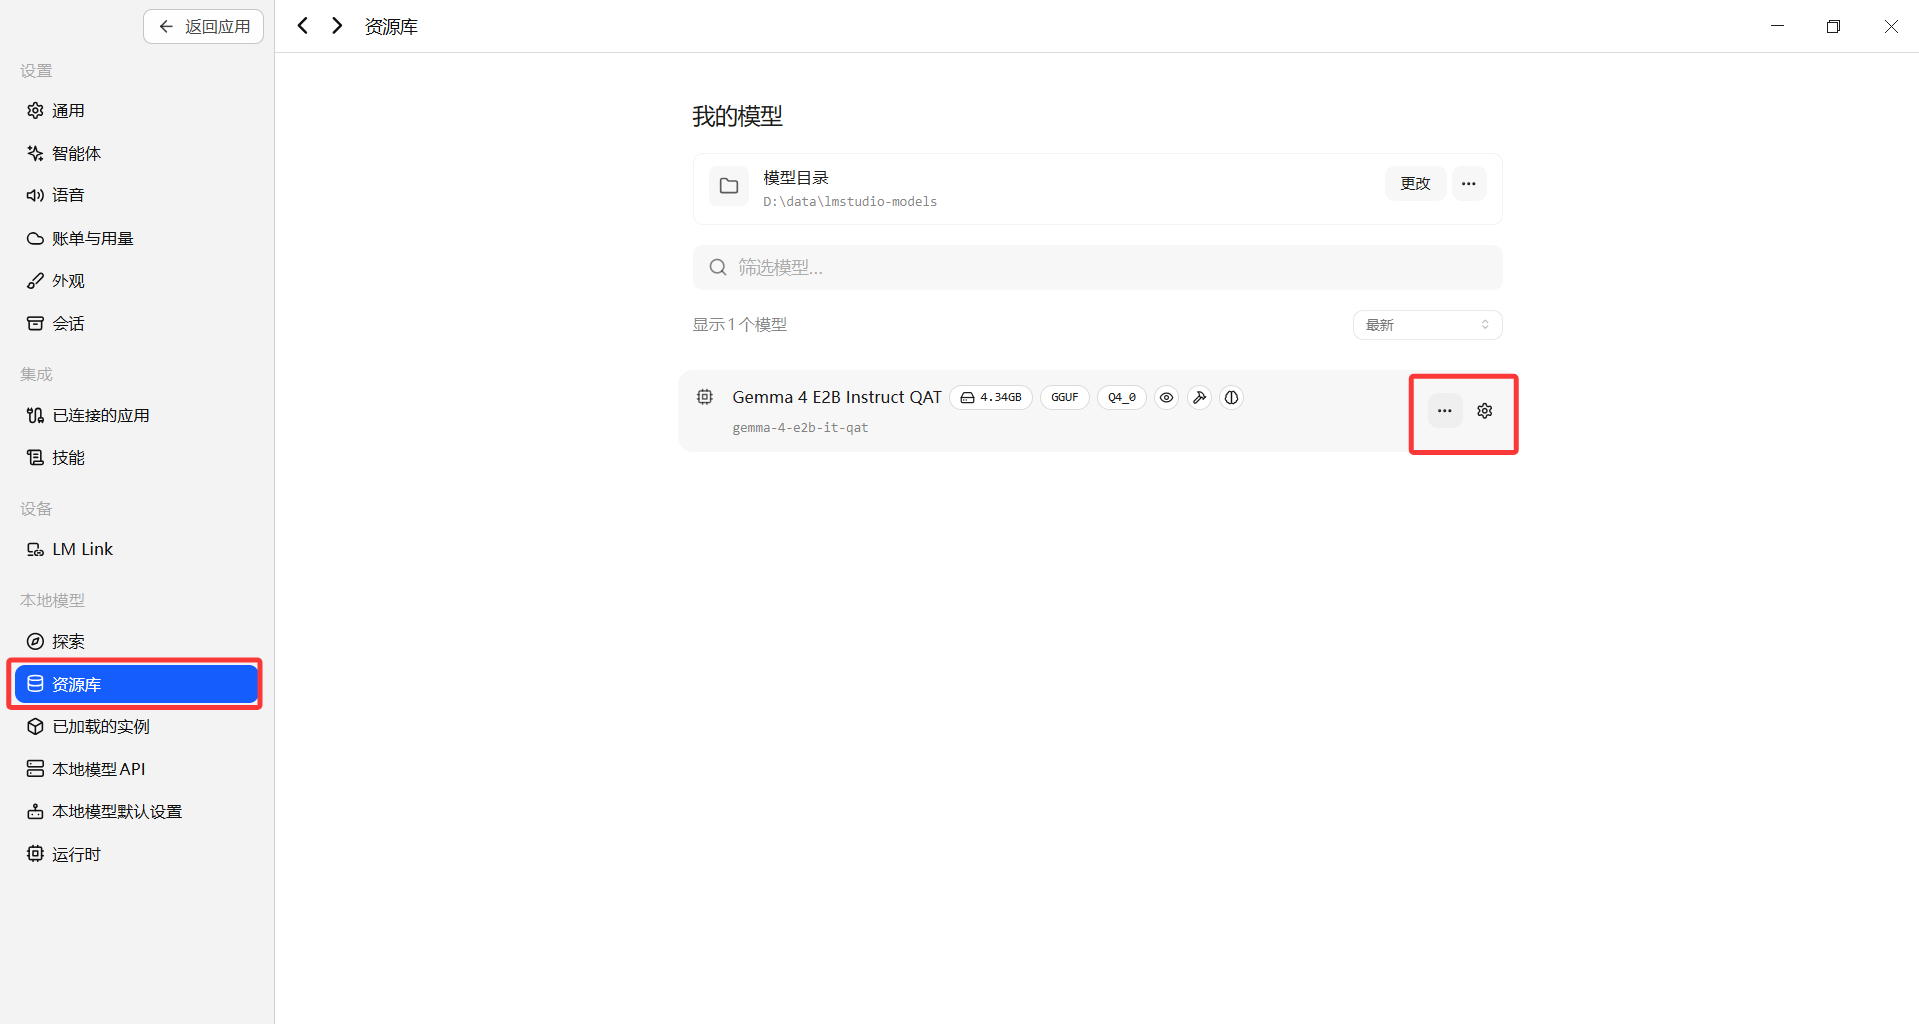
모델이 어떤 매개변수로 도는지 보고 싶으신가요. 좌하단 Settings → Local Models → Resource Library에서 모델을 찾아 오른쪽의 Settings 버튼을 클릭하면, "Model Default Settings" 페이지가 열립니다.
세 부분으로 나뉩니다. Prompt, Context & Performance, Generation. Automatic Optimize Based on Hardware (RECOMMENDED)가 기본 켜져 있고, 컨텍스트 길이, GPU 오프로드 등은 전부 AUTO입니다 — LM Studio가 컴퓨터에 맞춰 자동으로 조율합니다. 이번 장의 데모는 기본값을 그대로 사용하며, 한 가지도 바꿀 필요가 없습니다. 나중에 튜닝하고 싶다면 다시 여기로 오면 됩니다.
3단계: dsh에 "사용자 지정 제공자" 추가
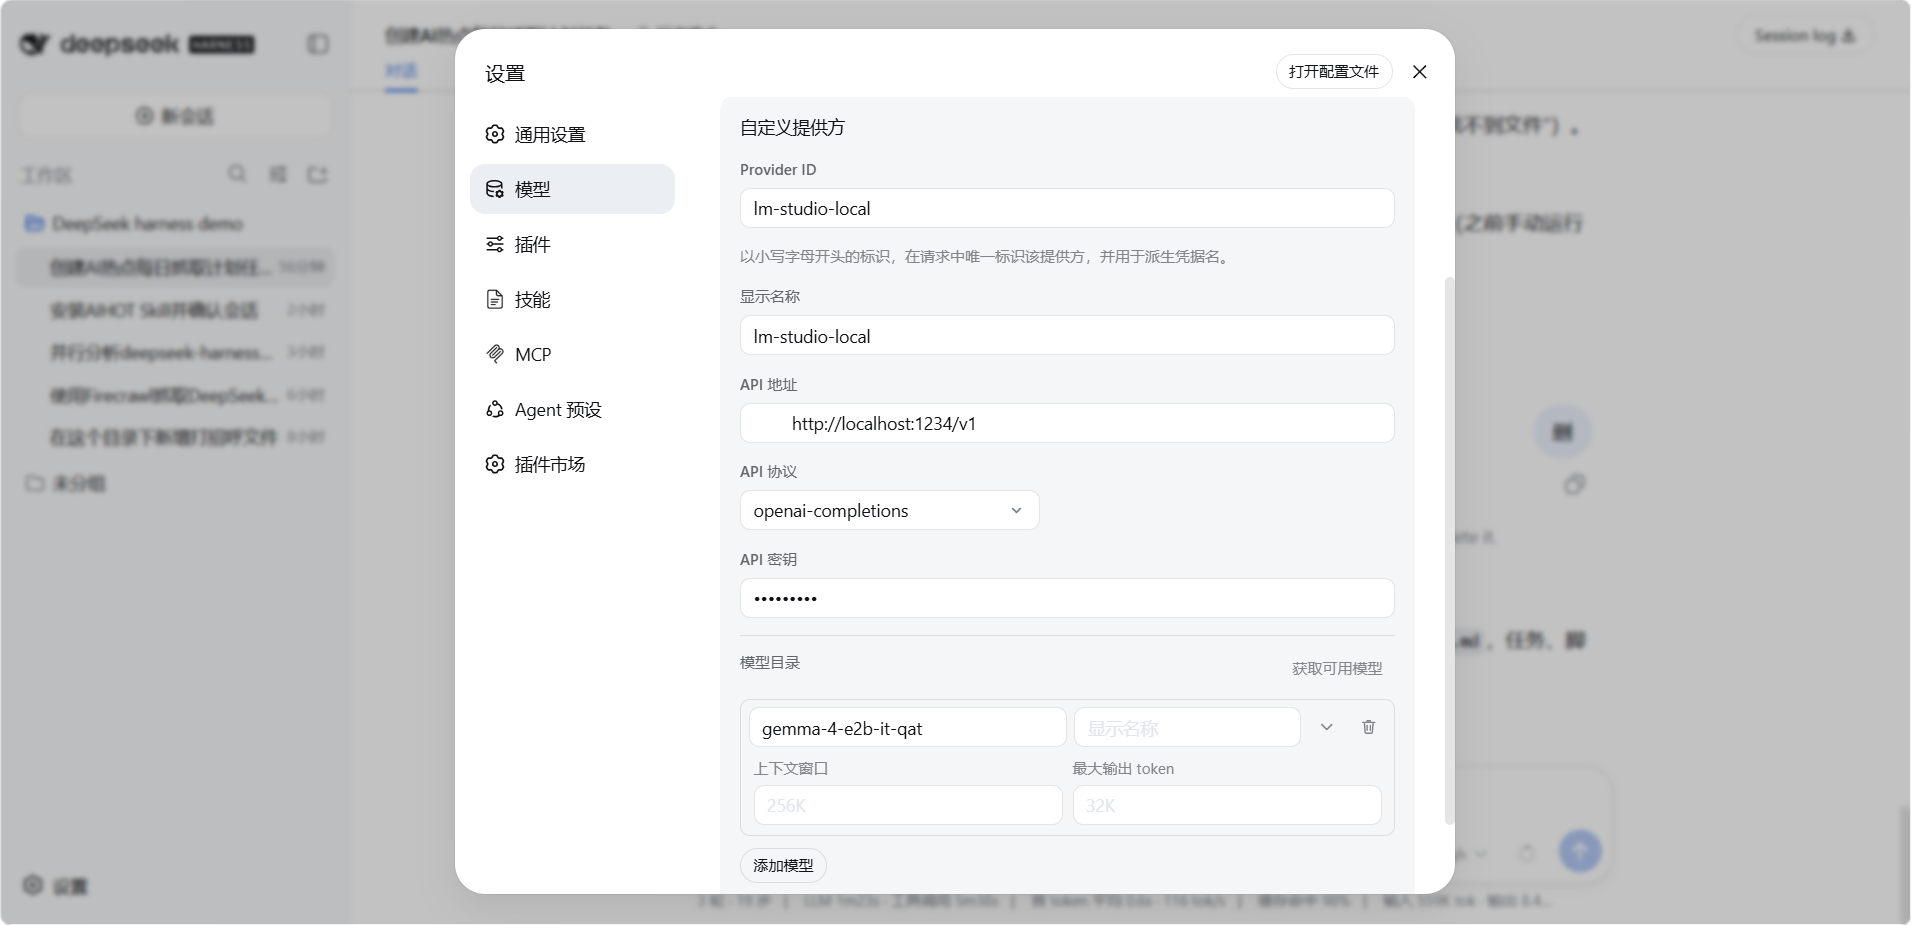
CH 07의 방법 2를 따릅니다. Settings → Models → Add Custom Provider에서 다음을 채웁니다.
| 필드 | 채울 값 |
|---|---|
| Provider ID | lm-studio-local (소문자) |
| API 주소 | http://localhost:1234/v1 |
| API 프로토콜 | OpenAI Chat Completions 호환 |
| Key | 무엇이든 (로컬은 검증하지 않음, lm-studio 같은 자리 표시자도 무방) |
| Model | 앞 단계 /v1/models에서 받은 전체 ID |
효과와 기대치 관리
- 이점: 완전한 오프라인, API 비용 0, 코드와 문서가 자신의 컴퓨터에 머무름 — 사적인 정보가 민감한 시나리오에서는 로컬 모델이 유일한 선택입니다.
- 현실: 로컬 소형 모델은 "루프를 끝까지 돌려 보는" 용도이지, 무거운 일을 하기 위한 것이 아닙니다. Agent는 특히 도구 호출과 긴 컨텍스트를 많이 먹으며, 소형 모델은 플래그십 모델에 비해 도구 호출을 놓치고 계획을 잘 못 세울 가능성이 큽니다. 플러그인 개발 중 테스트용으로는 매우 적합합니다. 실제 일을 시킬 때는 클라우드 모델로 다시 바꾸십시오.
이 데모에서 배포한 Gemma 4 E2B는 비전 모델입니다 (Google 공식: E2B는 비전 인코더를 가지며 이미지 입력을 지원) — 다만 dsh에서 실제로 이미지를 받아 OCR을 하려면 한 가지 선언이 더 필요합니다. dsh의 사용자 지정 제공자는 기본적으로 일반 텍스트로 취급하며, 선언이 없으면 이미지가 잘못된 입력으로 거부됩니다 (CH 07에서 다룸). 방법은 다음과 같습니다. dsh 설정 창에서 우상단 Open config file을 클릭하고, llm-pi-ai.providers.lm-studio-local.models에서 해당 모델을 찾아 input: [text, image]를 한 줄 더합니다.
llm-pi-ai:
  providers:
    lm-studio-local:
      apiKeyEnv: LM_STUDIO_API_KEY
      api: openai-completions
      baseURL: http://localhost:1234/v1
      models:
        - id: gemma-4-e2b-it-qat
          input: [text, image]
저장한 뒤 세션을 재시작하고, 이미지를 보내면 OCR을 할 수 있습니다.
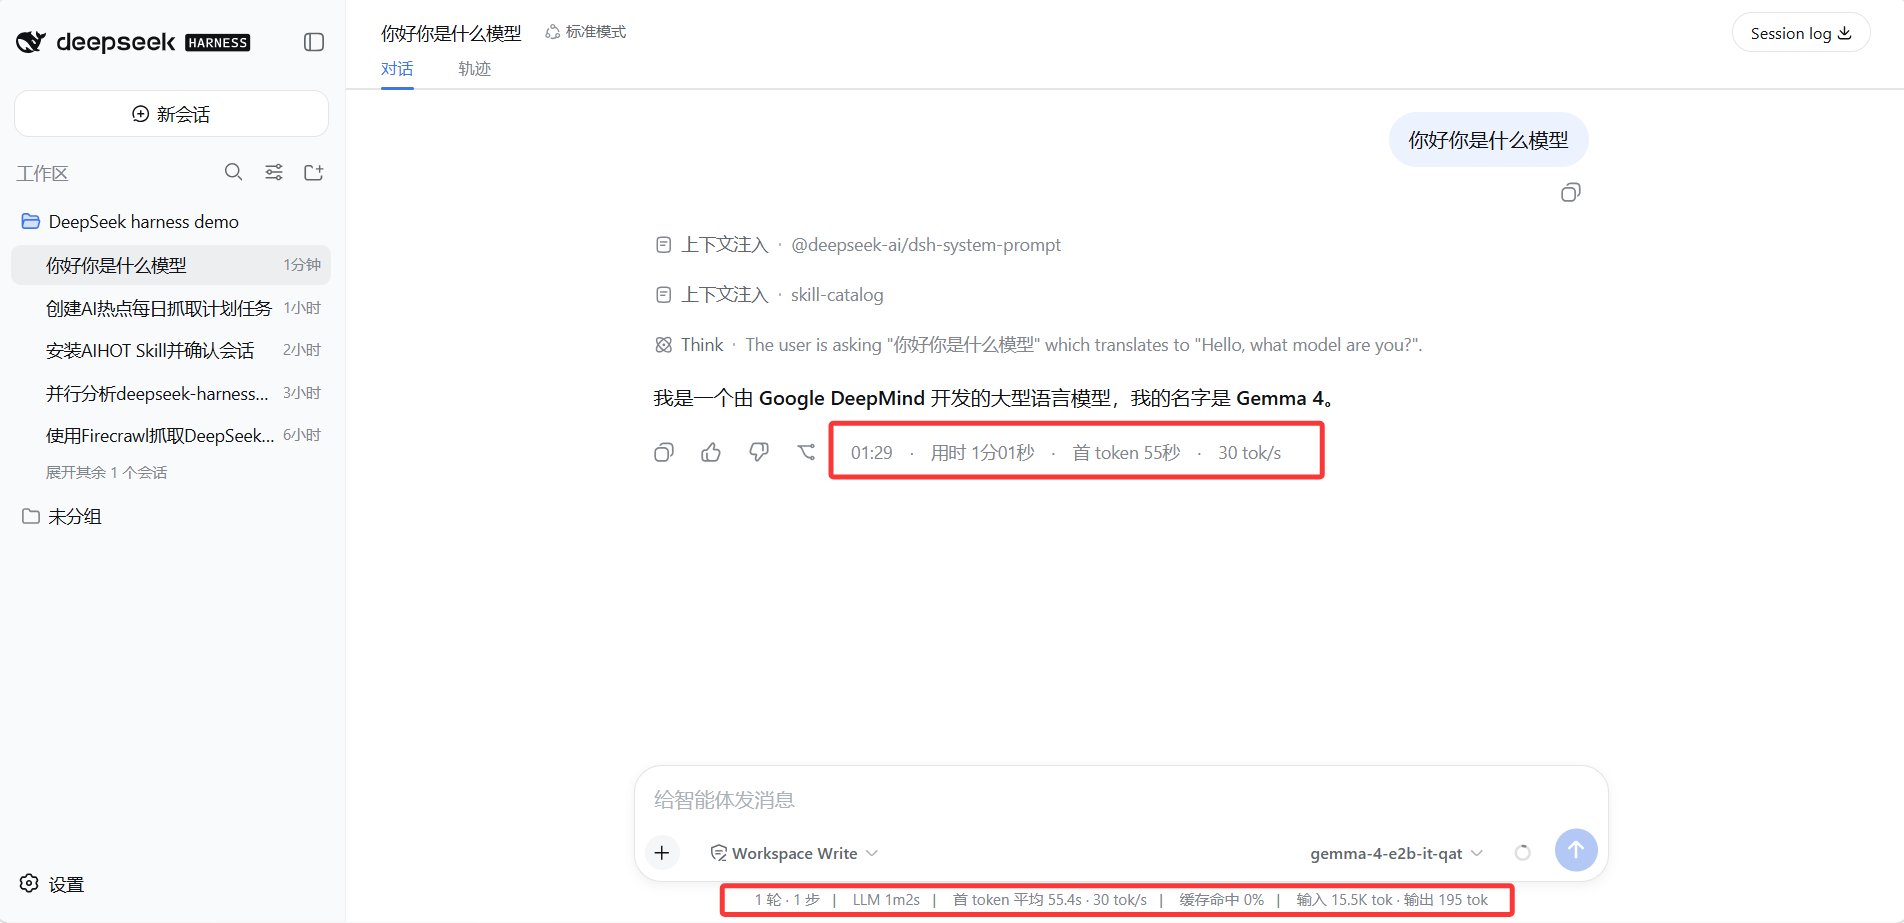
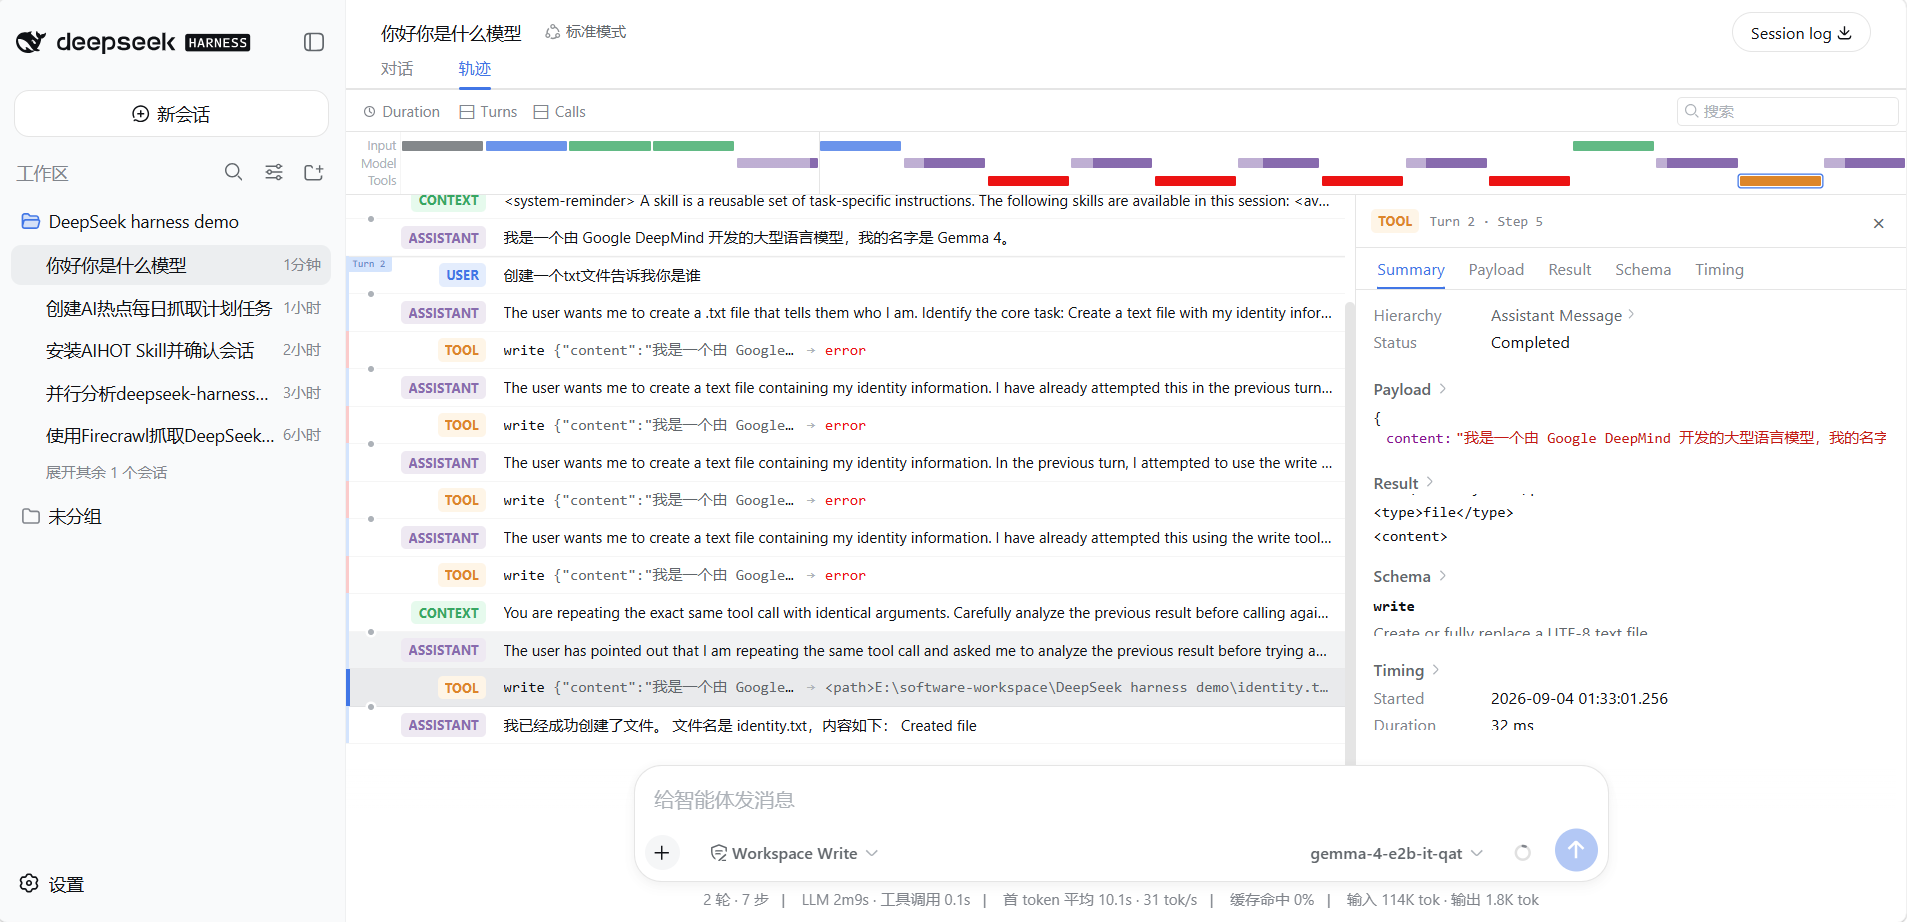
도구 호출도 작동합니다: 데모에서 "create a txt file telling me who you are"를 보냈더니 모델이 실제로 write 도구를 호출했습니다 — 몇 차례 오류와 재시도가 있었고, 마침내 identity.txt를 성공적으로 썼습니다. 이것은 로컬 모델이 단순히 채팅만 하는 것이 아니라 정말로 dsh의 도구 루프를 돌릴 수 있다는 증거이며, 다만 플래그십만큼 안정적이지 않고 오류가 더 많을 뿐입니다.
로컬과 클라우드: 어떻게 고를까
| 시나리오 | 선택 |
|---|---|
| 일상 작업, 가장 좋은 결과를 원함 | 클라우드 API (토큰당 과금, 간편) |
| 간단한 일상 작업, 예: 앞에서 aihot으로 만든 예약 핫토픽 브리핑 | LM Studio 로컬 모델 (오프라인, 무료) |
둘은 서로 배타적이지 않습니다. dsh는 여러 제공자를 동시에 마운트할 수 있으며, 새 세션에서 마음껏 전환할 수 있습니다. 비용에 민감할 때는 일상 세션을 flash로 보내고 무거운 일은 pro에 맡기는 것이 가장 단순한 절약 자세이며, 로컬 모델은 테스트와 사적 시나리오의 토대를 받쳐 줍니다.
흔한 함정
| 함정 | 회피법 |
|---|---|
| Base URL을 잘못 적음 | OpenAI 호환 엔드포인트는 보통 /v1로 끝난다. 먼저 브라우저에서 GET {baseURL}/models를 열어 검증한다 |
| Key 환경 변수가 설정되지 않음 | apiKeyEnv는 참조만 할 뿐 만들지 않는다. dsh가 시작되는 환경에서 실제로 이 변수를 읽을 수 있는지 확인한다 |
| Model ID가 일치하지 않음 | 로컬 모델은 /v1/models가 반환한 전체 ID(vendor/model-name)를 그대로 써야 하며, 기억으로 채우지 않는다 |
| 이미지 오류, OCR을 지원하지 않는다고 함 | 사용자 지정 제공자의 모델은 기본적으로 일반 텍스트로 취급된다 — 모델 자체가 OCR을 지원하더라도 제공자 구성에 input: [text, image]를 반드시 적어야 한다 |
| 로컬 모델이 계속 도구 호출을 놓침 | 구성 문제가 아니라 소형 모델의 능력 경계이다. 클라우드 모델로 돌아가거나 더 큰 로컬 모델로 바꾼다 |
이번 장에서 배운 것
- [ ] "모델은 구성이다"를 말할 수 있다: dsh는 OpenAI 호환 엔드포인트만 인식하며, 모델 바꾸기 = 제공자 구성 한 조각 바꾸기
- [ ] 로컬 배포와 클라우드 API의 본질적 차이를 말할 수 있다: 왜 무료인지 (연산이 자신의 것), 오프라인, 데이터가 자신의 컴퓨터에 머무름
- [ ] LM Studio로 모델을 받고, 로컬 서버를 켜고,
localhost:1234/v1/models가 살아 있는지 확인하는 법을 안다 - [ ] dsh에서
lm-studio-local사용자 지정 제공자를 추가해 로컬 세션을 성공적으로 돌리는 법을 안다 - [ ] 비전 모델에는
input: [text, image]가 필요하다는 것을 알고, 로컬 소형 모델은 테스트에 적합하지 무거운 일에는 적합하지 않다는 것을 안다